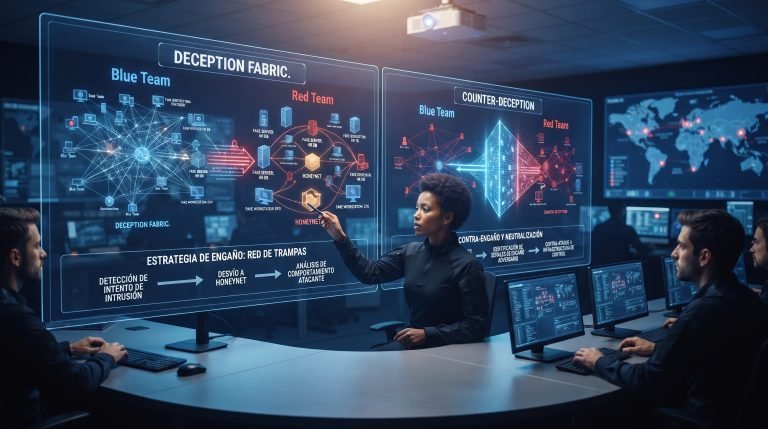
En el panorama tecnológico contemporáneo, la inteligencia artificial (IA) ha trascendido de ser una promesa futurista a una realidad omnipresente, impulsando innovaciones que redefinen industrias y transforman la vida cotidiana. Desde algoritmos predictivos en finanzas hasta sistemas de diagnóstico médico y vehículos autónomos, la eficacia y fiabilidad de la IA dependen intrínsecamente de la calidad y veracidad de los datos que la alimentan. No obstante, esta dependencia también expone a los sistemas de IA a una vulnerabilidad crítica: la manipulación maliciosa de datos. Salvaguardar la integridad de la información no es solo una cuestión técnica, sino un imperativo ético y estratégico que define la confianza y la utilidad a largo plazo de cualquier aplicación de inteligencia artificial.
La integridad de los datos se refiere a la exactitud, coherencia y fiabilidad de la información a lo largo de su ciclo de vida. En el contexto de la IA, esto significa que los datos utilizados para entrenar, validar y operar modelos deben ser auténticos, completos y estar libres de alteraciones no autorizadas o sesgos intencionales. La erosión de esta integridad puede tener consecuencias devastadoras, desde decisiones erróneas con impacto económico significativo hasta resultados injustos o discriminatorios, e incluso fallas críticas en sistemas de seguridad.
El fundamento de la inteligencia artificial: la verdad de los datos
La inteligencia artificial, en sus múltiples manifestaciones, es esencialmente un sistema de aprendizaje basado en patrones extraídos de grandes volúmenes de datos. Los modelos de aprendizaje automático, por ejemplo, desarrollan su capacidad para reconocer objetos, predecir tendencias o generar contenido al procesar y analizar conjuntos de datos extensos y, presumiblemente, representativos. Si estos datos iniciales están comprometidos, el modelo de IA heredará y amplificará esas deficiencias, propagando errores o sesgos a través de sus operaciones.
Consideremos un sistema de IA diseñado para evaluar solicitudes de crédito. Si el conjunto de datos de entrenamiento ha sido sutilmente modificado para incluir ejemplos falsos que favorecen a ciertos grupos o desfavorecen a otros, el modelo aprenderá a replicar y perpetuar ese sesgo. Las decisiones resultantes no solo serían injustas, sino que también erosionarían la confianza en el sistema y podrían acarrear implicaciones legales y reputacionales severas. De manera similar, en entornos críticos como la medicina o la conducción autónoma, la manipulación de datos de entrenamiento podría llevar a diagnósticos incorrectos o a fallos en la detección de obstáculos, con riesgos para la vida humana. Por ello, la veracidad del dato se convierte en el pilar ineludible sobre el cual se construye la robustez y la ética de toda solución de inteligencia artificial.
La anatomía de la manipulación maliciosa en entornos de IA
Los ataques a la integridad de los datos en la era de la IA son diversos y sofisticados, evolucionando a medida que los propios sistemas de inteligencia artificial se vuelven más complejos. Comprender la naturaleza de estas amenazas es el primer paso hacia la construcción de defensas efectivas.
Envenenamiento de datos (data poisoning)
El envenenamiento de datos es una de las formas más insidiosas de manipulación, donde un atacante introduce información errónea o maliciosa en el conjunto de datos de entrenamiento de un modelo de IA. El objetivo es corromper el proceso de aprendizaje del modelo, haciendo que aprenda patrones incorrectos o sesgados. Por ejemplo, en un sistema de detección de spam, un atacante podría introducir correos electrónicos legítimos etiquetados como spam, o viceversa, con el fin de evadir los filtros o saturar las bandejas de entrada. La sutileza de estos ataques radica en que los datos maliciosos pueden ser difíciles de detectar si se mezclan hábilmente con el volumen masivo de información legítima, llevando al modelo a un rendimiento degradado o a un comportamiento inesperado y perjudicial.
Ataques de inferencia de membresía
Estos ataques buscan determinar si un punto de datos específico fue parte del conjunto de entrenamiento de un modelo de IA. Aunque no modifican directamente los datos, comprometen la privacidad y la confidencialidad. Un ejemplo práctico sería un atacante que intenta verificar si su historial médico particular fue utilizado para entrenar un modelo de diagnóstico clínico. Si tiene éxito, esto podría revelar información sensible que se suponía anónima o protegida, violando la privacidad de individuos o la confidencialidad de organizaciones.
Evasión y ataques adversarios
Los ataques de evasión, también conocidos como ataques adversarios, implican la creación de entradas diseñadas específicamente para engañar a un modelo de IA entrenado. Estos ataques no alteran el conjunto de datos de entrenamiento, sino que manipulan las entradas en tiempo de ejecución. Por ejemplo, una imagen de un signo de alto puede ser modificada con pequeñas perturbaciones indetectables para el ojo humano, pero que hacen que un sistema de visión artificial la clasifique erróneamente como un límite de velocidad. El objetivo es causar que el modelo tome decisiones incorrectas, lo que puede tener implicaciones críticas en sistemas de seguridad, vehículos autónomos o reconocimiento facial.
Falsificación de datos sintéticos
Con el avance de las redes generativas adversarias (GANs) y otras técnicas de generación de datos, la creación de datos sintéticos realistas se ha vuelto una herramienta poderosa. Sin embargo, esta capacidad también puede ser explotada para la manipulación maliciosa. Un atacante podría generar conjuntos de datos sintéticos que parecen auténticos pero contienen sesgos o información falsa, para influir en la toma de decisiones de otros sistemas de IA o para fabricar evidencia que respalde narrativas engañosas. La dificultad radica en que estos datos pueden ser indistinguibles de los reales, complicando su detección y verificación.
Estrategias de defensa y resiliencia para la integridad de los datos
La protección contra la manipulación maliciosa de datos en la era de la IA exige un enfoque multifacético y robusto. No existe una solución única, sino una combinación de medidas técnicas, organizacionales y éticas.
Gobernanza y calidad de datos rigurosas
El establecimiento de una sólida gobernanza de datos es fundamental. Esto implica definir políticas claras para la adquisición, almacenamiento, procesamiento y eliminación de datos. La implementación de procesos de validación y limpieza de datos, la trazabilidad de la procedencia (linaje de datos) y la gestión de metadatos son cruciales. Se debe asegurar que cada dato utilizado en un sistema de IA tenga un origen verificable y que su calidad sea evaluada continuamente. La supervisión humana, aunque no escalable para todos los datos, sigue siendo indispensable en puntos críticos del ciclo de vida de los datos y en la interpretación de anomalías detectadas automáticamente.
Criptografía y tecnologías de privacidad
Las técnicas criptográficas ofrecen una capa de protección vital. La encriptación homomórfica, por ejemplo, permite realizar cálculos sobre datos cifrados sin necesidad de descifrarlos, protegiendo la privacidad de la información mientras se procesa. El aprendizaje federado permite entrenar modelos de IA utilizando datos distribuidos en múltiples dispositivos o ubicaciones sin que los datos brutos salgan de su fuente original. Las técnicas de privacidad diferencial añaden ruido estadístico a los datos para proteger la identidad de los individuos, sin afectar significativamente la utilidad del conjunto de datos para el entrenamiento de modelos.
Auditoría y monitoreo continuo
La vigilancia constante es esencial. Los sistemas de IA y sus fuentes de datos deben ser monitoreados de forma continua para detectar anomalías, cambios inesperados en los patrones de datos o en el comportamiento del modelo. Las auditorías regulares de los conjuntos de datos de entrenamiento y de los modelos desplegados pueden identificar vulnerabilidades o señales de manipulación. La implementación de registros inmutables, como los basados en tecnología de cadena de bloques (blockchain), puede ofrecer un registro transparente e inalterable de la procedencia y las modificaciones de los datos, dificultando la falsificación.
Robustez y explicabilidad de modelos
Diseñar modelos de IA que sean inherentemente más robustos a los ataques adversarios es una estrategia proactiva. Esto se logra mediante técnicas como el entrenamiento adversario, donde el modelo se expone a ejemplos manipulados durante su fase de aprendizaje para que aprenda a identificarlos y resistirlos. Además, la explicabilidad de la IA (XAI) es crucial, permitiendo a los desarrolladores y usuarios comprender cómo un modelo llega a sus decisiones. Un modelo más transparente es más fácil de auditar y sus posibles sesgos o vulnerabilidades son más fáciles de identificar y corregir.
Colaboración y estándares de la industria
La lucha contra la manipulación de datos en la IA no puede ser una tarea aislada. La colaboración entre investigadores, desarrolladores, reguladores y la industria es fundamental para compartir conocimientos, desarrollar mejores prácticas y establecer estándares de seguridad y ética. La creación de marcos regulatorios claros y la adopción de certificaciones de calidad y seguridad para los datos y modelos de IA pueden fomentar un ecosistema más seguro y confiable.
El imperativo ético y la confianza pública
Más allá de los aspectos técnicos, la integridad de los datos en la era de la IA se vincula directamente con la ética y la confianza pública. La manipulación, intencional o no, puede socavar la fe en los sistemas automatizados y generar escepticismo sobre su capacidad para operar de manera justa y equitativa. A medida que la IA se integra más profundamente en decisiones de alto impacto, desde la justicia penal hasta la asignación de recursos, la garantía de que los datos subyacentes son veraces y no han sido comprometidos se vuelve un pilar para la legitimidad social de estas tecnologías. Las organizaciones tienen la responsabilidad de no solo proteger sus sistemas, sino de ser transparentes sobre sus métodos y de construir mecanismos de rendición de cuentas que refuercen la confianza en la era digital.
Preguntas Frecuentes (FAQs)
¿Qué es la integridad de los datos en el contexto de la inteligencia artificial?
La integridad de los datos en la IA se refiere a la exactitud, consistencia y fiabilidad de la información utilizada por los sistemas de inteligencia artificial. Asegura que los datos para entrenamiento, validación y operación de modelos sean auténticos, completos y libres de alteraciones no autorizadas o sesgos maliciosos, siendo fundamental para el rendimiento y la confianza en la IA.
¿Cuáles son las consecuencias de una baja integridad de datos en los sistemas de IA?
Una baja integridad de datos puede llevar a modelos de IA sesgados, decisiones erróneas con graves implicaciones económicas o sociales, violaciones de privacidad, fallos de seguridad en sistemas críticos y una erosión general de la confianza en las tecnologías de inteligencia artificial. Las consecuencias pueden ir desde pérdidas financieras hasta riesgos para la vida humana.
¿Cómo se puede proteger la integridad de los datos contra el envenenamiento?
La protección contra el envenenamiento de datos implica una combinación de gobernanza rigurosa, validación y limpieza de datos continuas, trazabilidad del linaje de datos, monitoreo de anomalías en los conjuntos de datos, y el uso de técnicas de aprendizaje automático robustas que puedan identificar y mitigar la influencia de datos maliciosos durante el entrenamiento.
¿Qué papel juega la criptografía en la defensa de la integridad de los datos para la IA?
La criptografía es esencial para proteger la confidencialidad y la autenticidad de los datos. Técnicas como la encriptación homomórfica permiten procesar datos sin descifrarlos, mientras que las firmas digitales y los registros inmutables (como blockchain) garantizan la procedencia y que los datos no han sido alterados después de su creación o registro, fortaleciendo la integridad en todo el ciclo de vida.
La integridad de los datos en la era de la inteligencia artificial no es un lujo, sino una necesidad fundamental. Los desafíos son complejos y en constante evolución, requiriendo una combinación de innovación tecnológica, políticas robustas y un compromiso ético inquebrantable. Al adoptar un enfoque proactivo y multifacético, las organizaciones pueden no solo defenderse de la manipulación maliciosa, sino también construir sistemas de IA más confiables, justos y beneficiosos para la sociedad.